지난주에는 Controller에서 문자열을 반환하는 API를 만들었습니다. 그런데 코드를 돌아보니 Controller 객체를 직접 생성한 적은 없었습니다. 요청을 처리할 객체는 누가 만들고, 그 객체에 필요한 다른 객체는 어떻게 연결될까요? 이번 실습은 이 질문에서 시작해, 고정값을 반환하던 저장소를 Map과 DB로 차례로 바꾸는 과정으로 이어집니다.
1. IoC와 Bean: Spring이 객체를 관리하는 방식
Spring에서는 개발자가 모든 객체를 직접 생성하고 연결할 필요가 없습니다. 이 제어권을 프레임워크에 맡기는 원리가 IoC(Inversion of Control)입니다. Spring이 관리하는 객체를 Bean, 이 객체들을 생성하고 관리하는 곳을 IoC 컨테이너라고 합니다.
SpringApplication.run()이 반환하는 ApplicationContext에서 Bean의 이름과 개수를 조회해 보니, 직접 작성한 클래스 외에도 자동 구성으로 등록된 Bean이 여럿 있었습니다. 애플리케이션을 실행할 때 Spring이 준비하는 객체들을 볼 수 있는 부분입니다.
Bean의 기본 스코프는 싱글톤입니다. 같은 컨테이너에서 같은 Bean을 getBean()으로 두 번 조회하면 동일한 객체가 반환됩니다. 반면 new로 직접 만든 객체는 컨테이너가 관리하는 객체와 별개입니다.
여기서 싱글톤의 기준은 컨테이너 안의 Bean 정의 하나당 객체 하나입니다. 모든 Java 객체가 하나씩만 존재한다는 의미는 아닙니다. 여러 요청이 같은 Service Bean을 공유할 수 있으므로, 요청마다 달라지는 이름 같은 값은 필드에 남기지 않고 메서드 매개변수나 지역 변수로 다루는 편이 적절합니다. (Spring Bean 스코프 문서)
2. DI: 생성자 주입으로 객체 연결하기
객체를 만드는 일과 함께 필요한 작업이 객체 사이의 연결입니다. Controller가 Service를 사용하려면 Service 객체에 접근할 수 있어야 합니다. 이렇게 필요한 객체를 외부에서 전달받는 방식을 DI(Dependency Injection)라고 합니다. IoC가 제어권에 관한 원리라면, DI는 그 원리를 구현하는 방법 중 하나입니다.
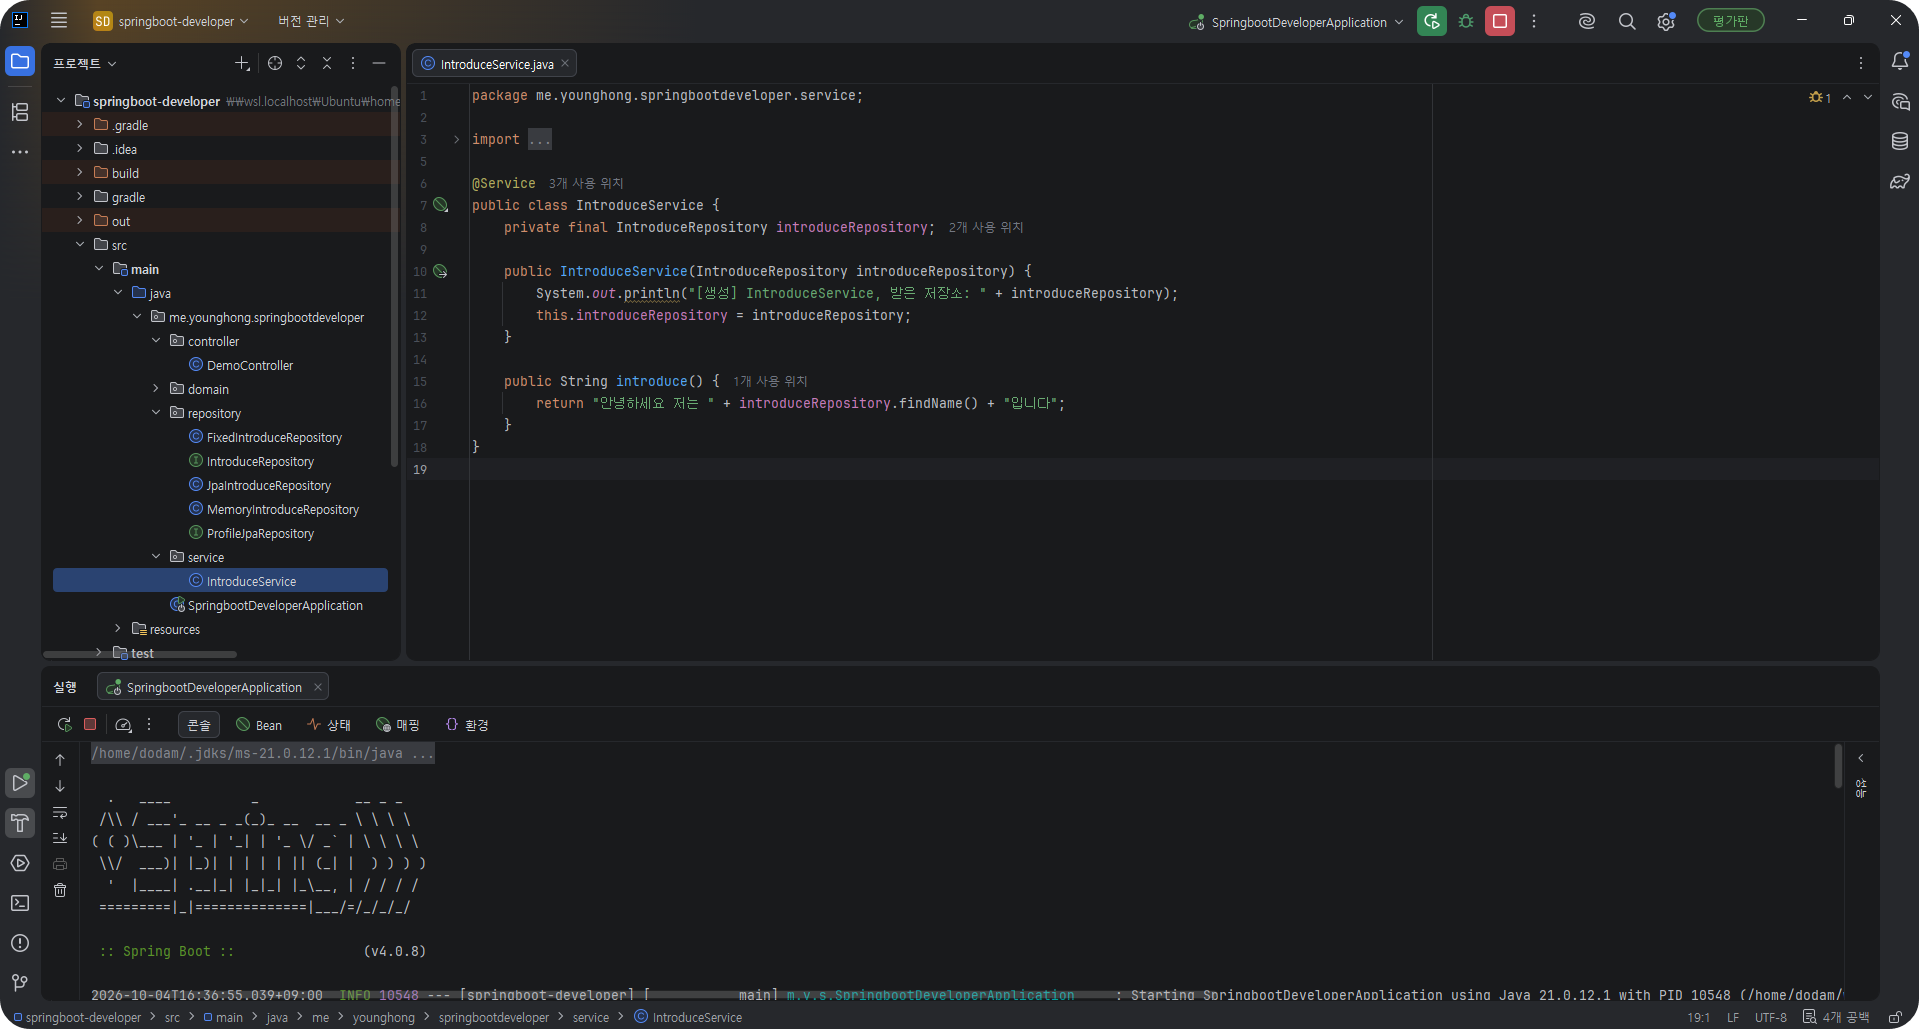
기존 Controller의 자기소개 로직을 IntroduceService로 옮기고 @Service를 붙였습니다. Controller에서는 Service를 직접 생성하는 대신, 생성자의 매개변수로 받습니다.
private final IntroduceService introduceService;

public DemoController(IntroduceService introduceService) {
    this.introduceService = introduceService;
}
Spring은 Controller를 만들 때 생성자에 필요한 Service Bean을 전달합니다. 생성자가 하나라면 @Autowired도 생략할 수 있습니다. 실습의 생성 로그에서도 Service가 먼저 만들어지고, 이를 전달받는 Controller가 뒤이어 생성됐습니다.
생성자만 봐도 이 클래스가 어떤 객체를 필요로 하는지 드러납니다. final 필드로 선언하면 생성 이후 참조가 바뀌는 것도 막을 수 있고, 테스트에서는 생성자에 테스트용 객체를 직접 전달할 수 있습니다. 필수 의존성을 명확하게 드러내고 객체를 초기화할 수 있다는 점은 Spring 공식 문서가 생성자 주입을 권장하는 이유이기도 합니다.
3. Bean 등록과 주입 오류로 이해하는 Spring의 동작
어노테이션을 하나씩 제거하면 객체들이 어떻게 연결되어 있는지 더 잘 드러납니다. 먼저 IntroduceService에서 @Service를 제거하자 애플리케이션이 시작되지 않았습니다. Controller는 여전히 Service를 요구하지만, Spring이 전달할 Bean이 없기 때문입니다. APPLICATION FAILED TO START 아래의 Description에 누락된 의존성이 표시됐습니다.
@RestController를 제거했을 때는 결과가 달랐습니다. 이 Controller를 요구하는 다른 Bean이 없는 실습 구조에서는 서버가 실행됐지만, 해당 경로로 요청을 보내면 404가 발생했습니다. 요청을 처리할 Controller가 등록되지 않은 상태인 것입니다. 어노테이션을 지웠다는 동작은 같아도, 빠진 Bean을 누가 필요로 하는지에 따라 실패하는 지점이 달라집니다.
주입할 Bean이 여러 개일 때도 선택 기준이 필요합니다. 같은 인터페이스를 구현한 Bean 중 하나에 @Primary를 붙이면 우선 후보로 사용할 수 있고, @Qualifier로 주입 후보를 좁힐 수도 있습니다. 이때 @Primary를 붙였다고 다른 Bean의 등록이 취소되는 것은 아닙니다.
이런 의존성 문제는 기본적으로 싱글톤 Bean을 미리 생성하는 기동 과정에서 드러납니다. 다만 지연 초기화를 사용하면 실제로 Bean이 필요한 시점까지 오류가 나타나지 않을 수도 있습니다. (Spring 의존성 해결 과정)
4. Controller–Service–Repository로 역할 나누기
자기소개 API의 코드는 다음 세 계층으로 나눴습니다.
- Controller: 요청 수신과 응답 반환
- Service: 비즈니스 로직 처리
- Repository: 데이터 저장과 조회
Service는 이름을 조회할 때 IntroduceRepository 인터페이스를 사용합니다. 처음에는 고정된 이름을 반환하는 FixedIntroduceRepository를 연결했고, 이후 Map에서 이름을 꺼내는 MemoryIntroduceRepository로 교체했습니다.
저장소를 바꿔도 Service와 Controller는 수정할 필요가 없었습니다. Service가 사용하는 기능은 여전히 findName()이기 때문입니다. 이름을 고정값으로 가져오는지, Map에서 꺼내는지는 저장소 구현이 담당합니다.
이 구조에서 역할과 구현의 분리가 드러납니다. IntroduceRepository는 이름을 조회한다는 역할을 정하고, Fixed·Memory·JPA 저장소는 각각의 방식으로 그 역할을 수행합니다. Spring은 DI를 통해 사용할 구현 객체를 연결합니다.
역할을 나누면 요구사항이 바뀌었을 때 살펴볼 코드도 분명해집니다. HTTP 요청 방식은 Controller, 자기소개 문장 규칙은 Service, 저장 방식은 Repository의 변경과 연결됩니다. 이처럼 서로 다른 책임을 구분하는 관점이 관심사의 분리(Separation of Concerns)입니다. 객체의 생성과 연결을 외부에 맡기면 각 클래스는 자신이 맡은 처리에 집중할 수 있습니다. (Spring DI 문서)
5. JPA와 H2로 메모리 저장소를 DB로 바꾸기
다음 단계는 Map에 있던 데이터를 DB로 옮기는 작업입니다. 객체와 관계형 데이터베이스의 테이블을 연결하는 기술을 ORM이라고 하며, JPA는 Java의 ORM 표준입니다. 이번에는 Spring Data JPA와 H2를 사용했습니다.
JPA, Hibernate, Spring Data JPA는 함께 등장하지만 맡은 역할이 다릅니다.
| JPA | Java 객체의 영속성과 매핑에 관한 표준 |
| Hibernate | JPA를 구현하고 SQL 생성과 객체 매핑을 수행하는 ORM |
| Spring Data JPA | Repository 인터페이스를 통해 JPA 사용을 편리하게 돕는 기능 |
표준과 구현체의 관계는 Hibernate 공식 가이드에, Repository 인터페이스를 사용하는 예제는 Spring Data JPA 입문 가이드에 나와 있습니다.
Spring Data JPA와 H2 의존성을 추가하고, 실습의 Spring Boot 4 환경에 맞춰 spring-boot-h2console도 넣었습니다. application.properties의 설정은 다음과 같습니다.
spring.h2.console.enabled=true
spring.datasource.url=jdbc:h2:mem:testdb
spring.jpa.show-sql=true
이름을 저장할 Profile 클래스에는 @Entity를, 식별자에는 @Id와 @GeneratedValue를 붙였습니다. 이어서 JpaRepository<Profile, Long>을 상속하는 인터페이스를 선언하면 save()와 findById() 같은 메서드를 사용할 수 있습니다. Spring Data JPA가 이 인터페이스를 위한 프록시 객체를 만들고 Bean으로 등록하기 때문에, 해당 메서드의 구현을 직접 작성할 필요가 없습니다.
마지막으로 JpaIntroduceRepository가 이 저장소를 주입받아 이름을 조회하도록 연결했습니다. 데이터를 저장한 뒤 /introduce를 호출하자 DB에 넣은 이름이 응답에 나타났습니다. 고정값에서 Map, 다시 DB로 저장 방식이 바뀌는 동안에도 Service와 Controller 코드는 그대로였습니다.
6. SQL 로그로 확인하는 객체와 테이블의 연결
spring.jpa.show-sql=true를 설정하면 Hibernate가 실행하는 SQL을 볼 수 있습니다. 실습에서는 다음 작업과 SQL이 대응됐습니다.
- 실습 환경의 애플리케이션 기동 시: Profile에 대응하는 CREATE TABLE
- save()로 새 객체를 저장할 때: INSERT
- /introduce에서 findById()로 조회할 때: SELECT
H2 콘솔에서 SELECT * FROM PROFILE;을 실행했을 때도 저장한 데이터가 나타났습니다. Java 코드에서 호출한 저장소 메서드가 Hibernate를 거쳐 실제 DB의 SQL 실행으로 이어지는 흐름입니다.
테이블이 자동으로 만들어진 데에는 실습 환경의 설정도 영향을 줍니다. Spring Boot는 H2 같은 내장 DB를 사용하고 Flyway·Liquibase 같은 스키마 관리 도구가 없으면 기본적으로 ddl-auto=create-drop을 선택합니다. 따라서 @Entity만 붙이면 모든 DB 환경에서 테이블이 자동 생성된다고 생각해서는 안 됩니다. (Spring Boot DB 초기화 문서)
ORM을 사용해도 객체 코드와 실제 SQL을 함께 읽을 필요가 있습니다. Hibernate 공식 가이드 역시 SQL에 대한 이해를 강조합니다. 이번에는 저장과 조회 메서드를 로그에 대응시켜 봤습니다. 같은 조회를 반복할 때도 매번 SQL이 실행되는지는 영속성 컨텍스트와 함께 더 살펴볼 부분입니다.
'배움 일기' 카테고리의 다른 글
| GDGOC 6th BE Week 2 - Backend와 Spring Boot로 첫 API 만들기 (0) | 2026.10.04 |
|---|---|
| Windows 데스크탑을 WSL + Tailscale + SSH 기반 원격 개발 서버로 구축하기 (0) | 2026.09.27 |
| Less is more, 바우하우스부터 조너선 아이브까지 (0) | 2026.03.01 |
| Tistory 스킨 'hELLO' HTML 커스텀하기 (0) | 2026.02.28 |
| 디자인 협업 툴, Figma의 기능들 기초 (0) | 2025.12.29 |